
Эта структура масштабирования подходит как при руководстве новыми командами и стартапами, так и для устоявшихся компаний с прочно укоренившейся культурой SRE.
Проблемы масштабирования команд SRE
Чем больше команда, тем сложнее общаться, координировать и поддерживать сплоченность команды. Ниже приведен список проблем, которые следует учитывать по мере роста организации:
- Быстрый рост. Приводит к созданию более сложных систем, которые могут превзойти возможности команды SRE, следовательно возникнут узкие места и снизится надежность.
- Обмен знаниями. Поддержание общего понимания систем и процессов может стать сложным, что снизит эффективную адаптацию новых членов команды.
- Инструменты и автоматизация. Масштабирование без соответствующих инструментов и автоматизации может привести к увеличению ручного труда, что снизит эффективность работы команды SRE.
- Реагирование на инциденты. Координация реагирования на инциденты также подвержена недопониманию или задержкам.
- Поддержание культуры инноваций и обучения. SRE могут больше концентрироваться на решении важнейших повседневных проблем и меньше — на новых инициативах.
- Баланс между эксплуатационной и инженерной работой. Поскольку специалисты по техническим вопросам отвечают как за эксплуатационные задачи, так и за инженерную работу, важно обеспечить, чтобы у этих групп было достаточно времени, чтобы сосредоточиться на обеих областях.
Структура масштабирования команд SRE
Масштабирование может произойти естественным образом, если вы делаете правильные вещи в правильном порядке.
- Во-первых, вы должны определить текущее состояние с точки зрения инфраструктуры.
- Определите существующие процессы SRE, которые требуют улучшения.
- Для процессов SRE, которые необходимы, но еще не используются, найдите инструменты и метрики, необходимые для старта.
Сотрудничайте с соответствующими заинтересованными сторонами, используйте обратную связь, итерируйте и улучшайте.
Шаг 1: Оцените текущее состояние
Создайте подробную карту своей инфраструктуры, сервисов и зависимостей. Определите все компоненты в инфраструктуре, включая серверы, базы данных, балансировщики нагрузки, сетевое оборудование и облачные сервисы.
Важно понимать, как эти компоненты взаимосвязаны и зависят друг от друга, какие сервисы полагаются на другие, какой поток данных между ними.
Также крайне важно выявить и оценить эффективность существующих практик SRE:
- Проанализируйте исторические данные об инцидентах для выявления повторяющихся проблем и путей их решения.
- Соберите отзывы от команды SRE и других заинтересованных сторон.
- Спросите их о болевых точках, проблемах и областях, где необходимы улучшения.
- Оцените показатели производительности, связанные с надежностью и доступностью системы.
- Определите тенденции или закономерности, указывающие на области, требующие внимания.
- Оцените, как сейчас обрабатываются инциденты: эффективно ли они решаются? проводятся ли проверки после инцидентов для предотвращения их повторения?
Шаг 2: Определите SLO и допустимый лимит ошибок
Сотрудничайте с заинтересованными сторонами для установления четких и значимых целей уровня обслуживания (SLO). Чтобы это сделать, вы должны понимать приемлемый уровень ошибок и представлять, как формировать Errors Budgets на основе SLO. Именно это поможет грамотно оптимизировать распределение ресурсов. Вычислительные мощности могут быть выделены в области, которые напрямую влияют на достижение SLO.
SLO устанавливают четкие, достижимые цели для команды и предоставляют измеримый способ оценки надежности сервиса. Определяя конкретные цели для времени безотказной работы, задержки или частоты ошибок, команды SRE могут объективно оценить, соответствует ли система желаемым стандартам производительности. А используя конкретные цели, команда может расставить приоритеты и сосредоточиться на областях, требующих улучшения.
Errors Budgets предоставляют механизм управления рисками и поиска компромиссов между надежностью и инновациями. Они позволяют группам SRE определять приемлемый порог для сбоев или ошибок обслуживания, что позволяет им сбалансировать необходимость развертывания новых функций или внесения изменений для поддержания надежного обслуживания.
Пример расчета: Если SLA/SLO определяет, что система должна быть доступна 99.9% времени, это означает, что 0.1% времени в месяц (или около 43 минут) система может быть недоступной или работать с ошибками. Эти 43 минуты — это и есть Errors Budget.
Шаг 3: Создайте и обучите свою команду SRE
Определите таланты в соответствии с потребностями каждого шага этой структуры. Ищите правильный набор навыков и соответствие культуре, и обязательно предоставьте комплексные программы адаптации и обучения для новых SRE.
Остерегайтесь золотого правила, что культура ест стратегию на завтрак: наличие правильной стратегии и процессов важно, но без правильной культуры ни одна стратегия или процесс не будут успешными в долгосрочной перспективе.
Шаг 4: Внедрение процессов SRE, автоматизация, итерация и улучшение
Внедрите процедуры управления инцидентами и анализа после инцидента. Определите процесс безопасных и эффективных изменений в системе.

Анализируя инциденты и их первопричины, SRE могут выявлять закономерности и вносить необходимые улучшения для предотвращения возникновения подобных проблем в будущем. Этот непрерывный процесс улучшения имеет решающее значение для повышения общей надежности и производительности, обеспечивая эффективность систем в масштабе. Так что модернизация и масштабирование команды могут идти рука об руку.
Мониторинг
Мониторинг — первый шаг в обеспечении надежности и производительности системы. Он подразумевает непрерывный сбор данных о поведении, производительности и работоспособности системы.
Мониторинг здесь можно разбить на:
- Сбор данных.
- Наблюдение в реальном времени.
- Проактивный или реактивный подход. Эффективный мониторинг позволяет заблаговременно обнаруживать и решать проблемы, снижая необходимость в реактивном тушении пожаров.
Оповещение
- Пороги и условия — оповещения срабатывают на основе предопределенных порогов или условий. Например, оповещение может быть настроено на срабатывание, когда использование ЦП превышает 90% в течение пяти последовательных минут.
- Каналы уведомлений. Оповещения могут отправляться по различным каналам уведомлений, включая электронную почту, SMS или пейджер, или даже интегрироваться в инструменты управления инцидентами.
- Уровни серьезности. Оповещения следует классифицировать по уровням серьезности (например, критические, предупреждающие, информационные), чтобы обозначить срочность и влияние проблемы.
Рекультивация
Она включает в себя меры по устранению проблем, обнаруженных с помощью мониторинга и оповещения. Цель состоит в том, чтобы быстро смягчить или устранить проблемы, чтобы свести к минимуму их воздействие на пользователей.
- Автоматизированные действия. Например, автоматизированная система масштабирования может добавлять больше ресурсов на сервер при высокой загрузке ЦП.
- Playbooks – SRE следуют предопределенным playbooks, которые описывают шаги по устранению неполадок и решению распространенных проблем. Playbooks обеспечивают последовательность и эффективность во время усилий по исправлению.
- Ручное вмешательство. В некоторых случаях для решения сложных или непредвиденных проблем может потребоваться ручное вмешательство со стороны SRE или других членов команды.
Управление инцидентами
Эффективная коммуникация, обмен знаниями и обучение имеют решающее значение во время инцидента, и большинство инцидентов можно воспроизвести в промежуточных средах для целей обучения. Регулярные обновления предоставляются заинтересованным сторонам, включая пользователей, руководство и другие команды.
Цель состоит не только в разрешении инцидента, но и в предотвращении его повторения.
Надежный процесс управления инцидентами гарантирует, что сбои в обслуживании будут оперативно устранены, тем самым повышая доверие и удовлетворенность пользователей. Кроме того, эффективно управляя инцидентами, SRE помогают сохранить непрерывность бизнес-операций и минимизировать потенциальные потери доходов.
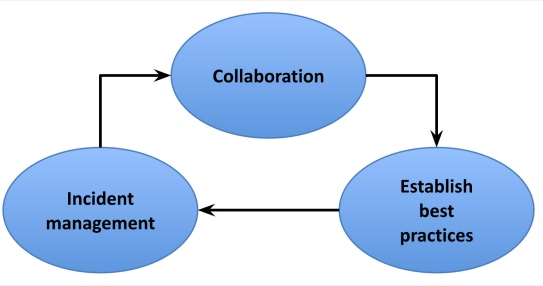
Управление инцидентами играет важную роль в процессе масштабирования, поскольку оно устанавливает лучшие практики и способствует сотрудничеству.
По мере масштабирования системы частота и сложность инцидентов, вероятно, возрастут. Четко определенный процесс управления инцидентами позволяет команде SRE эффективно управлять растущей рабочей нагрузкой.
Заключение
В конце концов, ваши процессы SRE должны быть интегрированы в весь процесс разработки, тестирования и развертывания, как показано на рисунке.
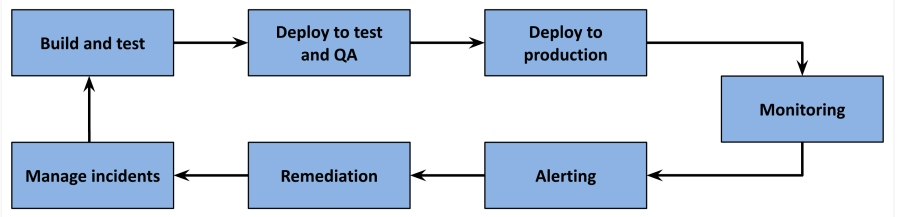
Повторение и совершенствование вышеперечисленных шагов приведет к увеличению объема работы для команд SRE; однако эта работа может проложить путь к устойчивому масштабированию команд SRE в правильном темпе.
Следуя этой структуре и преодолевая трудности, вы можете эффективно масштабировать свою команду SRE, сохраняя при этом надежность системы и способствуя культуре сотрудничества и инноваций. Помните, что SRE — это непрерывный путь, и важно оставаться приверженным каноничным принципам и практикам.