


Ошибки конфигурации Kubernetes: что нашли исследователи
Исследователи Mostafa Anouar Ghorab, Ahmad Abdel Latif и Mohamed Aymen Saied изучили 2662 обращения разработчиков о безопасности Kubernetes со Stack Overflow, Helm-чарты и данные нескольких инструментов статического анализа, чтобы построить таксономию типичных ошибок конфигурации. Работа опубликована на arXiv 22 сентября 2026 года и вошла в материалы конференции AIware 2026. Критические уязвимости, выяснили авторы, не исчезают по мере роста проекта.
Краткий ответ
Исследование на 2662 обсуждениях со Stack Overflow, Helm-чартах и данных нескольких статических анализаторов показало: критические ошибки безопасности конфигурации Kubernetes не снижаются с ростом проекта, хотя часть операционных проблем со временем исчезает. Авторы предлагают использовать LLM не как автономного исправляющего агента, а как генератор правок внутри конвейера с детерминированной schema-валидацией — такой гибрид доводит точность исправления до 98,50%, тогда как отдельная модель достигает 89,06%.
Как исследователи собрали таксономию ошибок
Авторы объединили три источника данных: 2662 developer-reported обращения со Stack Overflow о проблемах безопасности в конфигурациях Kubernetes, набор Helm-чартов и результаты нескольких инструментов статического анализа. На этой основе они построили таксономию повторяющихся уязвимостей, сгруппировав находки в пять основных разделов по типам конфигурационных объектов и категориям проблем. Исследование также фиксирует разброс серьёзности: тяжесть ошибок заметно отличается в зависимости от категории, и не все проблемы конфигурации одинаково опасны для продакшена.
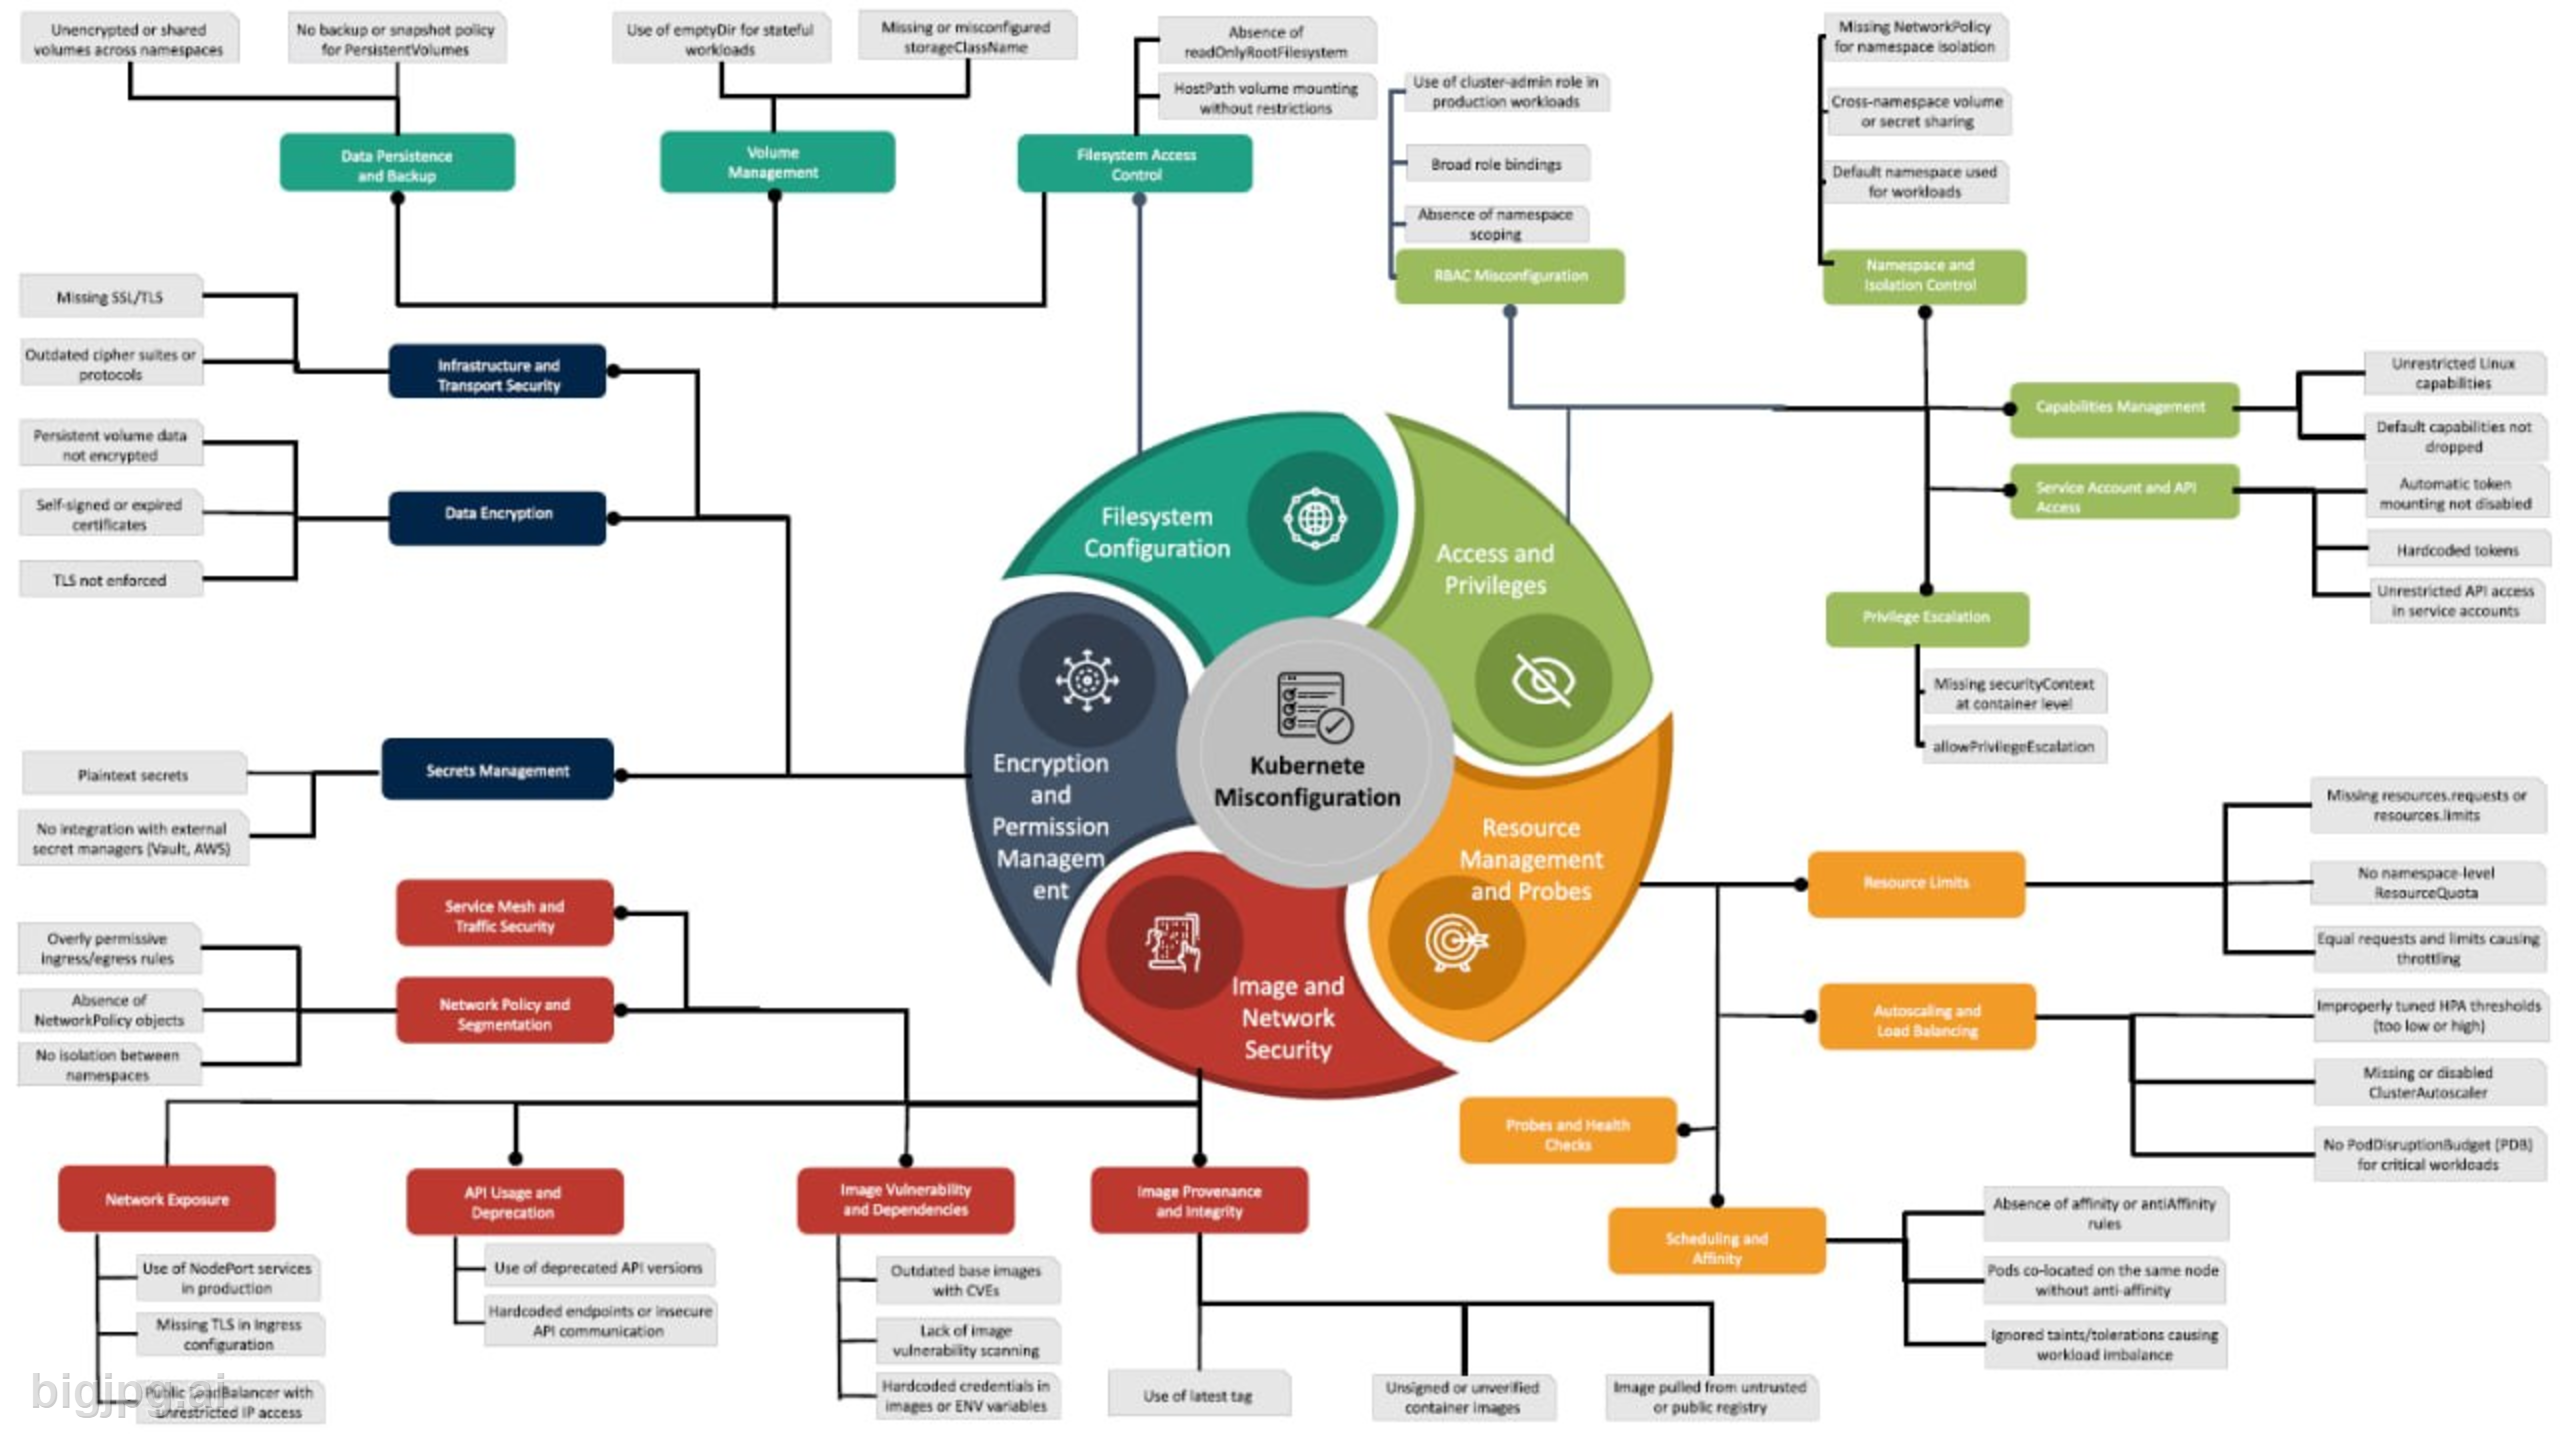
Что происходит с ошибками по мере роста проекта
Отдельная часть работы отслеживает, как меняются ошибки конфигурации между стадиями incubator и stable. Результат неожиданный с виду, но логичный для практики: часть операционных проблем со временем действительно уходит — команды дорабатывают процессы, учатся на инцидентах. А критические ошибки безопасности либо остаются, либо появляются снова даже в зрелых проектах. Зрелость кодовой базы не равна зрелости её конфигурации безопасности.
Как LLM справляются с исправлением ошибок
Авторы тестировали большие языковые модели на автоматическом исправлении найденных ошибок при постепенно обогащаемом контексте — чем больше модели давали информации о проекте и окружении, тем точнее результат. Лучшая отдельная модель вышла на точность исправления 89,06%. Чтобы закрыть оставшийся разрыв, команда представила Kubecurity — фреймворк схемо-управляемой валидации, который проверяет исправления по официальным спецификациям Kubernetes API. Комбинация рассуждений LLM с детерминированной проверкой схемы довела точность исправления до 98,50%, заметно сократив число новых ошибок, которые могла внести сама модель.
Гибрид надёжнее автономной генерации, но не автопилот
Авторы формулируют вывод аккуратно: LLM стоит использовать не как самостоятельного исправляющего агента, а как генератор правок внутри конвейера с детерминированной schema- и policy-валидацией. Такой гибрид в разы надёжнее «чистой» генерации исправлений — 98,50% против 89,06% у модели без валидации. Но до безопасного автопилота для Kubernetes-конфигураций, по выводам авторов, ещё далеко. Все эксперименты проходили в статике: исследователи проверяли корректность исправленных манифестов по схемам и спецификациям, но не запускали их в реальном кластере. Выборка из Stack Overflow и Helm-чартов также не покрывает все классы проблем конфигурации, которые встречаются на практике.
Почему это важно
Результат — сдержанный сигнал для платформенных команд, которые рассматривают LLM как автофикс для YAML-манифестов: без детерминированной проверки по схеме модель оставляет заметный процент неисправленных ошибок, а сам гибрид пока проверен только в статике, без прогона в реальном кластере. Для internal developer platforms и GitOps-пайплайнов с автоматическими ревью PR это означает, что генеративный слой нужно сочетать со статической валидацией — условным аналогом OPA, kubeval или встроенных admission-контроллеров, а не доверять исправлению одной модели.
Что дальше
Полная таксономия из пяти разделов, которую авторы публикуют в составе работы, может быть полезной отправной точкой для приоритизации проверок в CI/CD — какие категории конфигурации закрывать статическими правилами первыми. Если в контуре уже используется LLM для подсказок по конфигурации Kubernetes, разумно добавить отдельный шаг schema-валидации перед мерджем и не полагаться на точность модели как на финальный результат — тем более что авторы проверяли свой подход только в статике, без прогона исправлений в реальном кластере.
FAQ
Что такое Kubecurity?
Это фреймворк схемо-управляемой валидации, предложенный авторами исследования. Он проверяет сгенерированные LLM исправления конфигурации Kubernetes на соответствие официальным спецификациям Kubernetes API и помогает отсекать структурно некорректные правки до их применения.
Какие данные легли в основу исследования?
Авторы использовали три источника: 2662 обращения разработчиков со Stack Overflow о безопасности конфигураций Kubernetes, набор Helm-чартов и результаты нескольких инструментов статического анализа.
Какая точность исправления ошибок у LLM без schema-валидации?
Лучшая отдельная модель в исследовании достигла точности исправления 89,06% при максимально обогащённом контексте.
Почему критические ошибки конфигурации не исчезают с ростом проекта?
Авторы фиксируют сам факт: операционные проблемы со временем снижаются, а критические ошибки безопасности персистируют или появляются повторно. Конкретные причины такого разрыва в абстракте работы не раскрываются.
Где опубликована работа?
Препринт выложен на arXiv 22 сентября 2026 года, статья вошла в материалы конференции AIware 2026 — 3rd ACM International Conference on AI-Powered Software.