


Как Atlassian снизила время обнаружения инцидентов до 10 секунд
Инженеры Atlassian переписали конвейер обнаружения инцидентов и снизили задержку от события до метрики с более 40 секунд до менее 10, то есть почти в четыре раза. Компания описала переход в кейс-стади, которое опубликовала CNCF 30 сентября 2026 года: старая схема строилась на общей очереди и Node.js-агрегаторе, новая опиралась на OpenTelemetry, Apache Kafka и Apache Flink на Kubernetes.
Краткий ответ
Atlassian переписала конвейер детекции инцидентов на OpenTelemetry, Apache Kafka и Apache Flink на Kubernetes и снизила задержку от события до метрики с более 40 секунд до менее 10. Recall при этом колебался от 60% до пика 86%, затем упал до 64% в один из месяцев, а precision остаётся ниже целевого уровня. Event-driven архитектура решает проблему скорости, но не снимает отдельную работу над точностью детекции.
Цена сорока секунд в схеме Atlassian
Автор кейс-стади — Дипак Бисвас, старший инженерный менеджер направления Central Monitoring and Disaster Recovery в Atlassian. По его описанию, компания управляет более чем десятью облачными продуктами для миллионов тенантов. Каждый продукт отправляет клиентскую операционную телеметрию по каждому действию пользователя: старт задачи, успех, ошибка или отказ, с тегами тенанта, пользователя, конкретного пользовательского сценария и HTTP-статуса. Суммарно это миллиарды событий в день — и это единственный надёжный сигнал о том, может ли клиент вообще работать с продуктом.
Задача центрального мониторинга — превратить этот поток в три ответа, и быстро: что-то пошло не так, насколько это масштабно и кого будить. Первое поколение системы Atlassian решало это Node.js-агрегатором, который читал события из шины через облачную очередь, с кешем в памяти для дедупликации, на примерно 90 виртуальных машинах.
Система работала, но принесла три проблемы, которые не удавалось исправить тюнингом. Первая — задержка: событие доходило до метрики дольше 40 секунд в хороший день, а детекторам затем требовались ещё минуты накопленных данных в окне. Вторая — шумные соседи: очередь была общей инфраструктурой, и два инцидента за год случились из-за задержки другого тенанта в той же очереди. Третья — стоимость росла с каждым подключённым продуктом: с $120 тыс. до $230 тыс. в год, а кеш-слой во время обычного изменения выходил на 100% CPU.
Обнаружился и фундаментальный изъян в логике именно этой схемы. Клиентская телеметрия существует только тогда, когда загружается страница. Упавший шард базы данных даёт тишину, а не поток ошибок. Детектор, настроенный искать только ошибки, читает тишину как здоровье.
Что инженеры Atlassian переписали
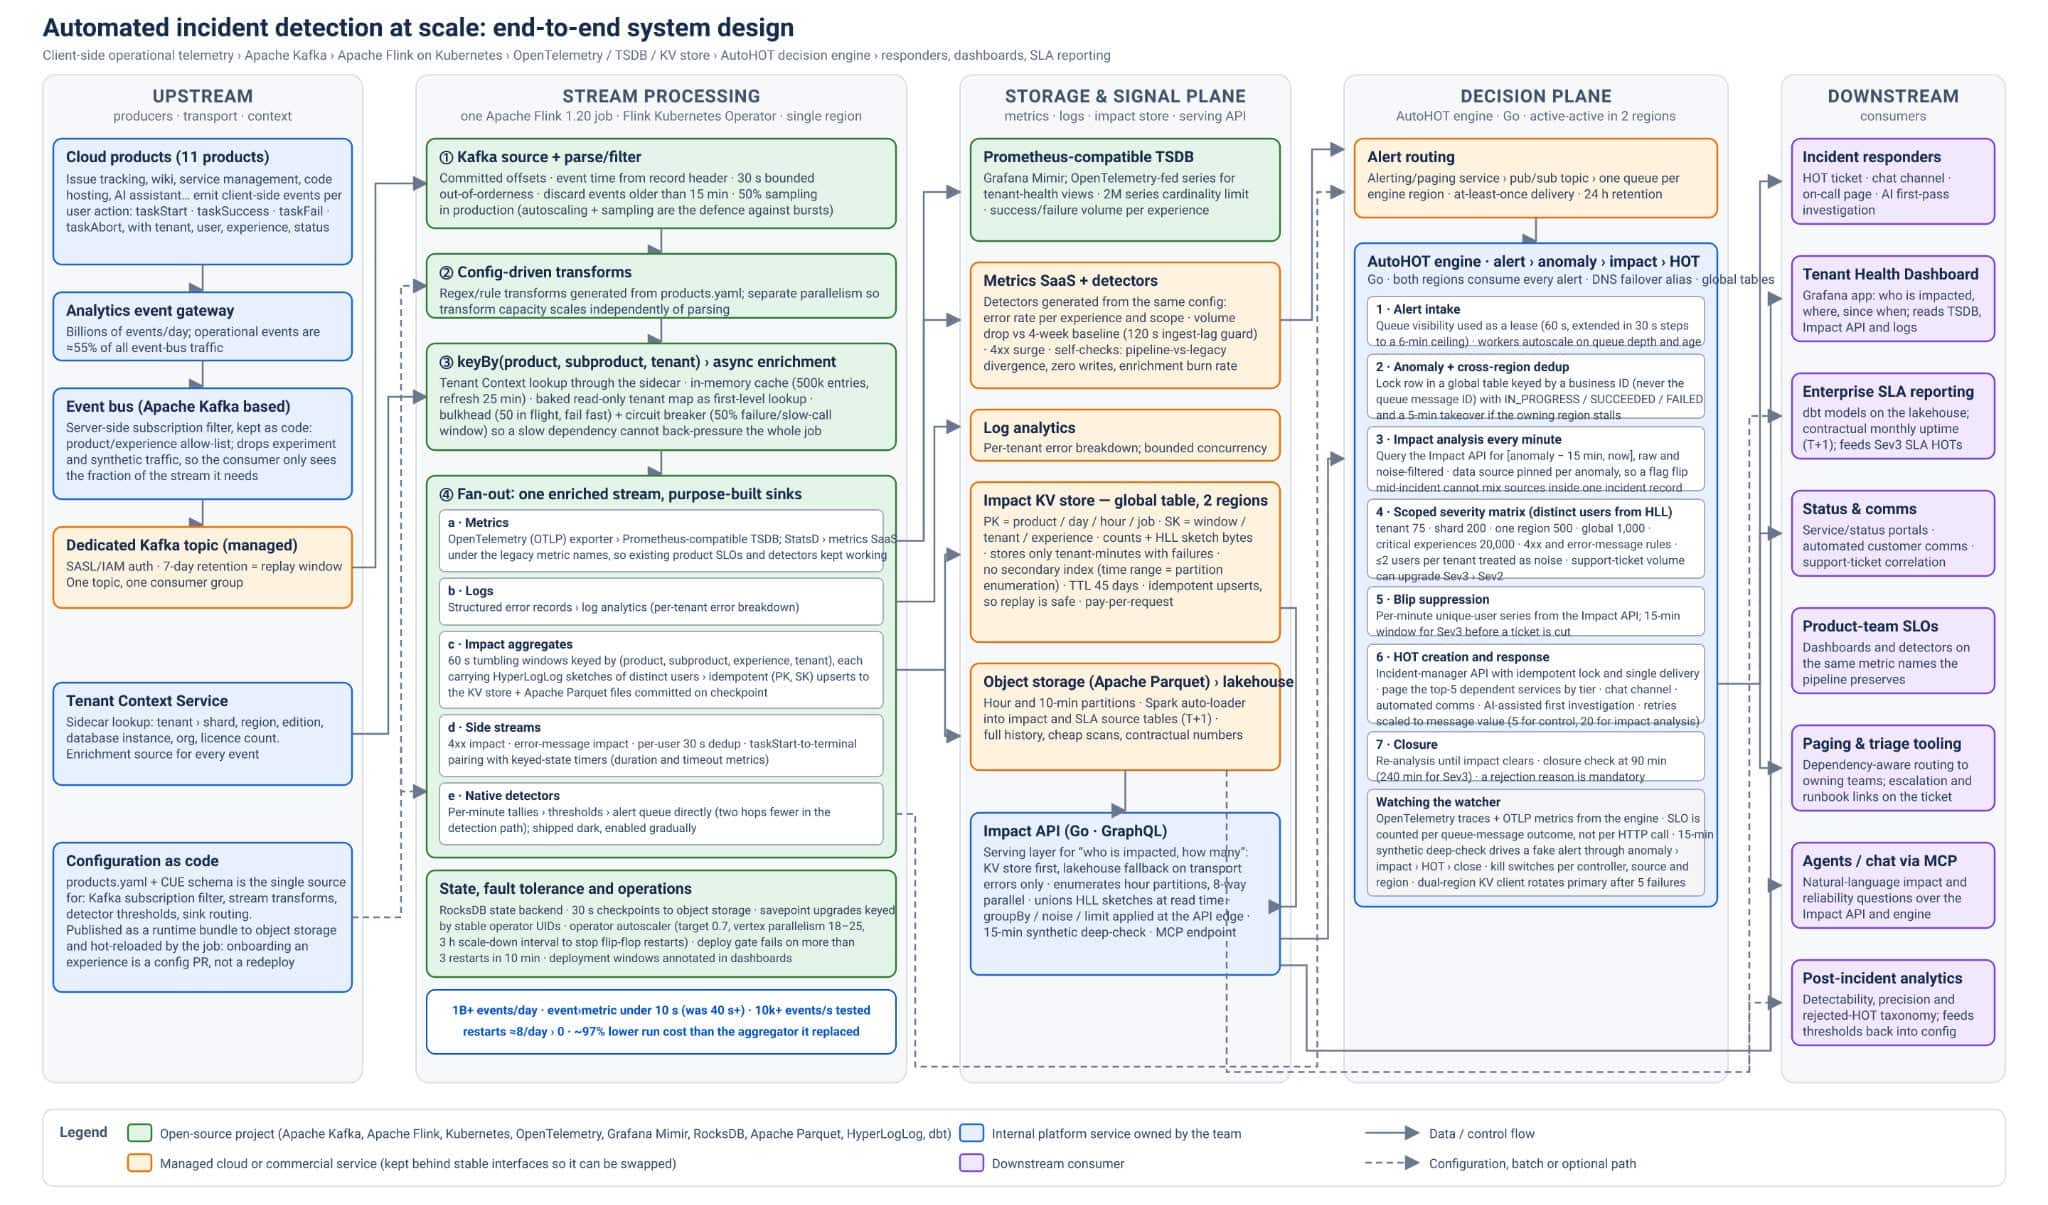
Команда сформулировала пять целей до выбора технологий: задержка от события до метрики быстрее 10 секунд, изоляция от общей очереди, идемпотентная запись при replay, стоимость, растущая с объёмом событий, а не с числом подключённых сценариев, и эксплуатируемость через единый конфигурационный источник.
Под эти цели легла связка из трёх проектов. OpenTelemetry — CNCF-стандарт для сбора метрик, трейсов и логов — собирает операционную телеметрию без промежуточной буферизации, которая создавала задержку в старой схеме. Apache Kafka переносит события в реальном времени по выделенному топику вместо общей очереди. Apache Flink, развёрнутый на Kubernetes через Flink Kubernetes Operator, обрабатывает поток и считает агрегаты с низкой задержкой вместо батчевого Node.js-агрегатора.
Архитектура делит систему на зоны: зелёные блоки — открытый код, янтарные — управляемые или коммерческие сервисы за стабильными интерфейсами, синие — сервисы, которые команда держит сама. Финальное решение о том, кого будить и с какой доказательной базой, принимает система AutoHOT — внутреннее название для автоматического создания инцидентов высокой серьёзности, где HOT расшифровывается как high-severity incident.
Что показали цифры за 18 месяцев
Главный результат — задержка от события до метрики упала ниже 10 секунд, а решение детектора теперь привязано к следующей минутной границе вместо накопления данных окнами в несколько минут.
Но Atlassian не стала рисовать картину красивее, чем она есть. In-scope recall — доля реальных инцидентов в зоне ответственности системы, которые она действительно обнаружила — стартовал около 60%, дошёл до пика 86%, а затем в один плохой месяц упал обратно до 64%. Precision, то есть доля сработавших алертов, которые оказались реальными инцидентами, по признанию команды, ещё ниже целевого уровня.
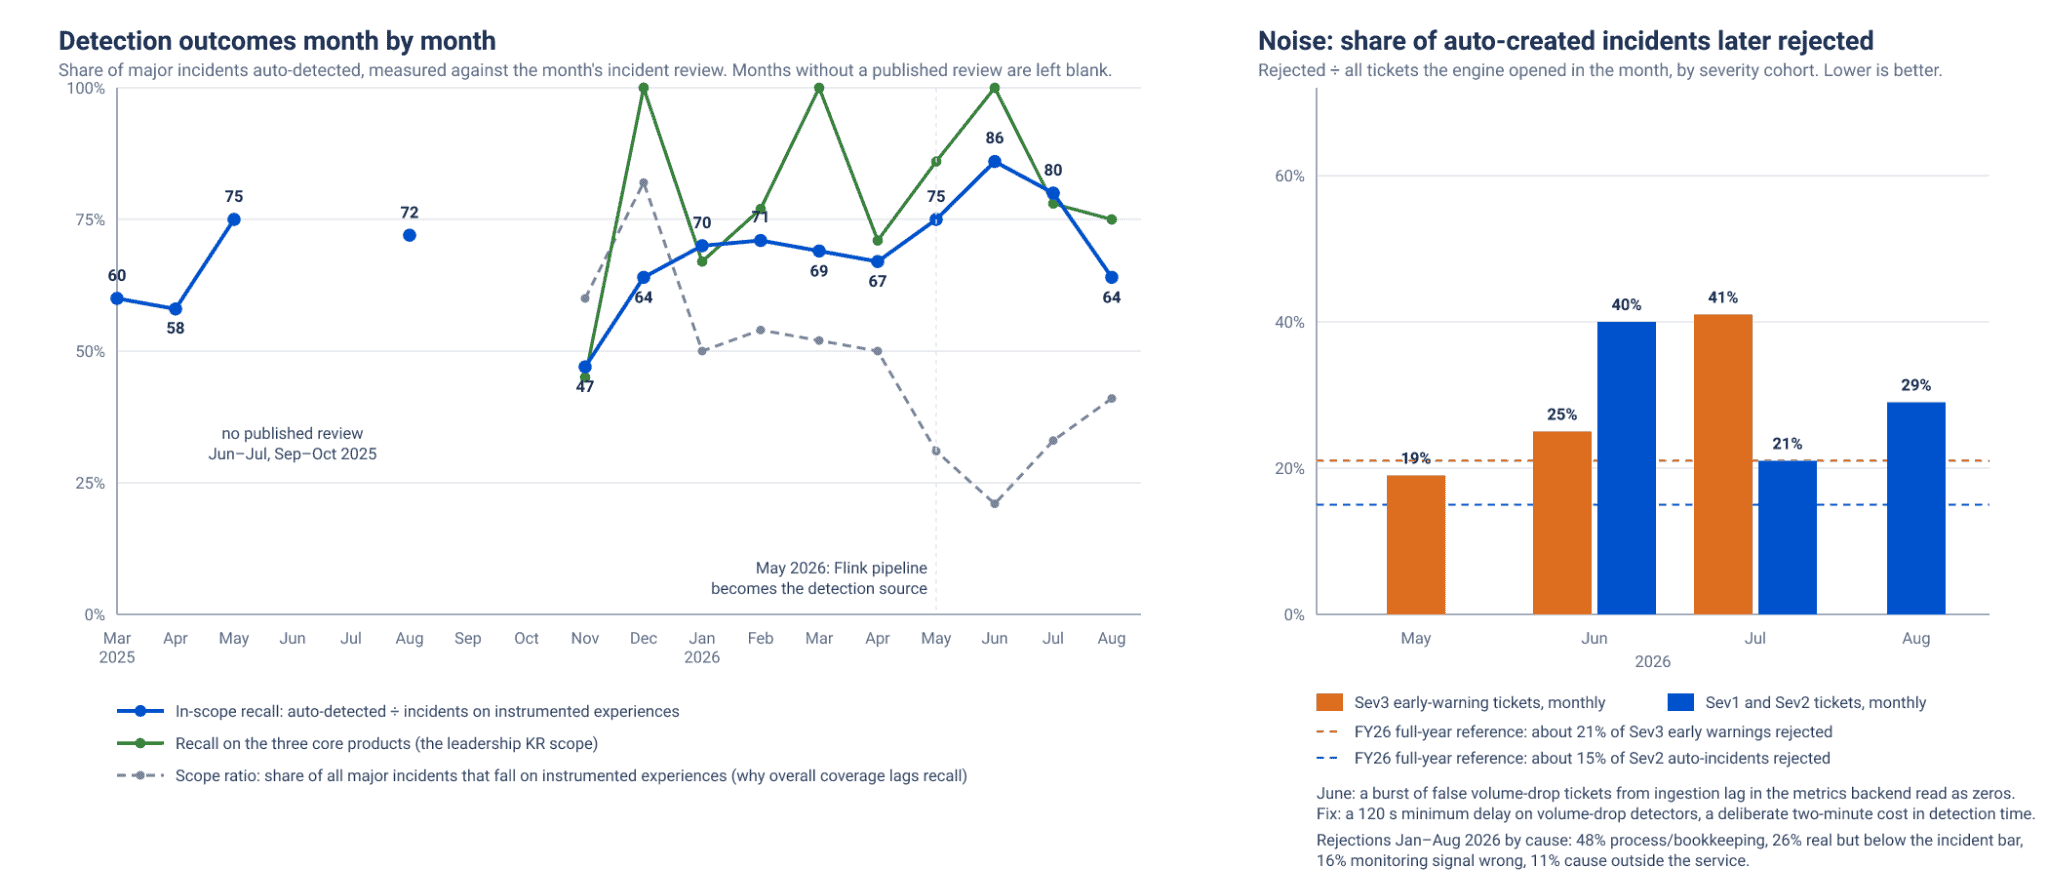
Авторы кейс-стади прямо пишут: это не success story с красивым бантом, а набор цифр за полтора года наблюдений, которые полезнее слоганов.
Что здесь спорно
Снижение задержки с 40 до менее 10 секунд — это инженерная победа над инфраструктурой: новая архитектура убрала общую очередь, убрала батчевую агрегацию, дала изоляцию и идемпотентность. Но задержка и точность детекции — разные метрики, и вторая не улучшилась автоматически вместе с первой.
Падение recall с 86% до 64% за один месяц показывает, что event-driven конвейер у Atlassian не гарантировал стабильность качества детекции сам по себе. Логика определения того, что считать инцидентом, продолжает требовать отдельной настройки, мониторинга дрейфа и, вероятно, ручной калибровки порогов по сезонности нагрузки и поведению продуктов. Команда также признаёт нерешённую проблему тишины как сигнала: отсутствие событий из-за упавшего шарда базы данных остаётся сложнее поймать, чем явный всплеск ошибок, даже на новой архитектуре.
Это важно для тех, кто читает заголовок про «10 секунд» и планирует повторить этот путь: быстрая доставка метрики не равна надёжному алерту, и выводы кейса относятся к конкретной системе Atlassian, а не к индустрии в целом.
Как приложить к своей команде
Для платформенных и SRE-команд, которые рассматривают переход с батчевого мониторинга на событийную архитектуру, кейс Atlassian даёт практический ориентир, а не готовый рецепт.
Во-первых, стоит формулировать цели до выбора инструментов — Atlassian зафиксировала пять конкретных метрик (задержка, изоляция, корректность, стоимость, эксплуатируемость) прежде чем выбирать Kafka, Flink и OpenTelemetry. Во-вторых, изоляция инфраструктуры мониторинга от общих очередей продукта напрямую снижает риск того, что сама система детекции станет источником инцидента — именно так произошло в старой схеме Atlassian дважды за год. В-третьих, идемпотентность записи важна не меньше скорости: без неё replay потока во время сбоя сам создаёт ложное завышение влияния на пользователей.
Для CTO, который рассматривает CNCF-стек как альтернативу проприетарным SaaS-решениям мониторинга, главный вывод не в том, что связка бесплатна или проще в эксплуатации — она требует отдельной команды и 18 месяцев итераций, судя по собственному описанию Atlassian. Событийная архитектура снимает проблему задержки почти полностью, но не снимает с команды задачу постоянно калибровать точность детекции — это отдельная, не менее трудоёмкая работа.
Заключение
История Atlassian — это не рекламный пример идеального перехода, а честный отчёт о компромиссах в рамках одной конкретной системы. Задержка упала в разы, но recall и precision продолжают колебаться даже спустя полтора года работы над системой. Для инженерных команд, которые смотрят на этот кейс как на образец, это сигнал: переход на OpenTelemetry, Kafka и Flink на Kubernetes решает инфраструктурную часть проблемы детекции, но не заменяет работу над логикой самих детекторов.
FAQ
Что такое AutoHOT у Atlassian?
AutoHOT — внутреннее название системы автоматического создания инцидентов высокой серьёзности в Atlassian, где HOT расшифровывается как high-severity incident. Система решает, есть ли проблема, насколько она масштабна и кого будить, на основе клиентской операционной телеметрии.
Чем событийный конвейер Atlassian отличается от прежнего батчевого мониторинга?
Старая схема Atlassian читала события из общей очереди через Node.js-агрегатор с кешем в памяти, и событие доходило до метрики дольше 40 секунд. Новая схема на OpenTelemetry, Apache Kafka и Apache Flink на Kubernetes убрала общую очередь из критического пути и обрабатывает события по мере поступления, что и дало задержку ниже 10 секунд в этом конкретном кейсе.
Что такое MTTD и почему 10 секунд имеют значение в этом кейсе?
MTTD (Mean Time To Detect) — среднее время от возникновения проблемы до её обнаружения мониторингом. В системе Atlassian каждая секунда задержки увеличивала число пользователей, которые заметят сбой раньше мониторинга — именно эту задержку компания снизила с 40+ секунд до менее 10.
Можно ли повторить переход Atlassian без такого объёма трафика?
Принципы — изоляция от общих очередей, идемпотентная запись, конфигурация через pull request вместо деплоя — применимы и на меньшем масштабе. Но сама Atlassian потратила на итерации 18 месяцев и признаёт нестабильность recall даже после перехода, так что результат не гарантирован автоматически с переходом на тот же стек.
Что случилось с precision и recall после перехода на новую архитектуру?
In-scope recall вырос с примерно 60% до пика 86%, но затем упал до 64% в один из месяцев наблюдения. Precision, по словам команды, остаётся ниже целевого уровня: задержка снизилась, но точность детекции инцидентов продолжает требовать отдельной калибровки.